
武汉基地首批成果:具身数据集下载破 1700 万,1100 多个真实场景采集点
蚂蚁数科武汉高质量数据基地公布首批成果:具身数据集全球下载量突破 1700 万,采集从基地走进车间、门店和家庭。标注岗位的形态,正在从「对着屏幕画框」变成「描述人在做什么」。
被媒体称作「机器人职业学院」的蚂蚁数科武汉高质量数据基地,近日交出首批数据成果:其具身数据集全球下载量突破 1700 万,已服务国内超 80% 的具身智能厂商。基地由蚂蚁数科与武汉市硚口区政府合作共建,2026 年 8 月 5 日揭牌启用,首批 9 家生态企业签约入驻,覆盖数据采集、精细加工、质量检测及具身智能应用开发等环节。
数据是从真实动作里来的
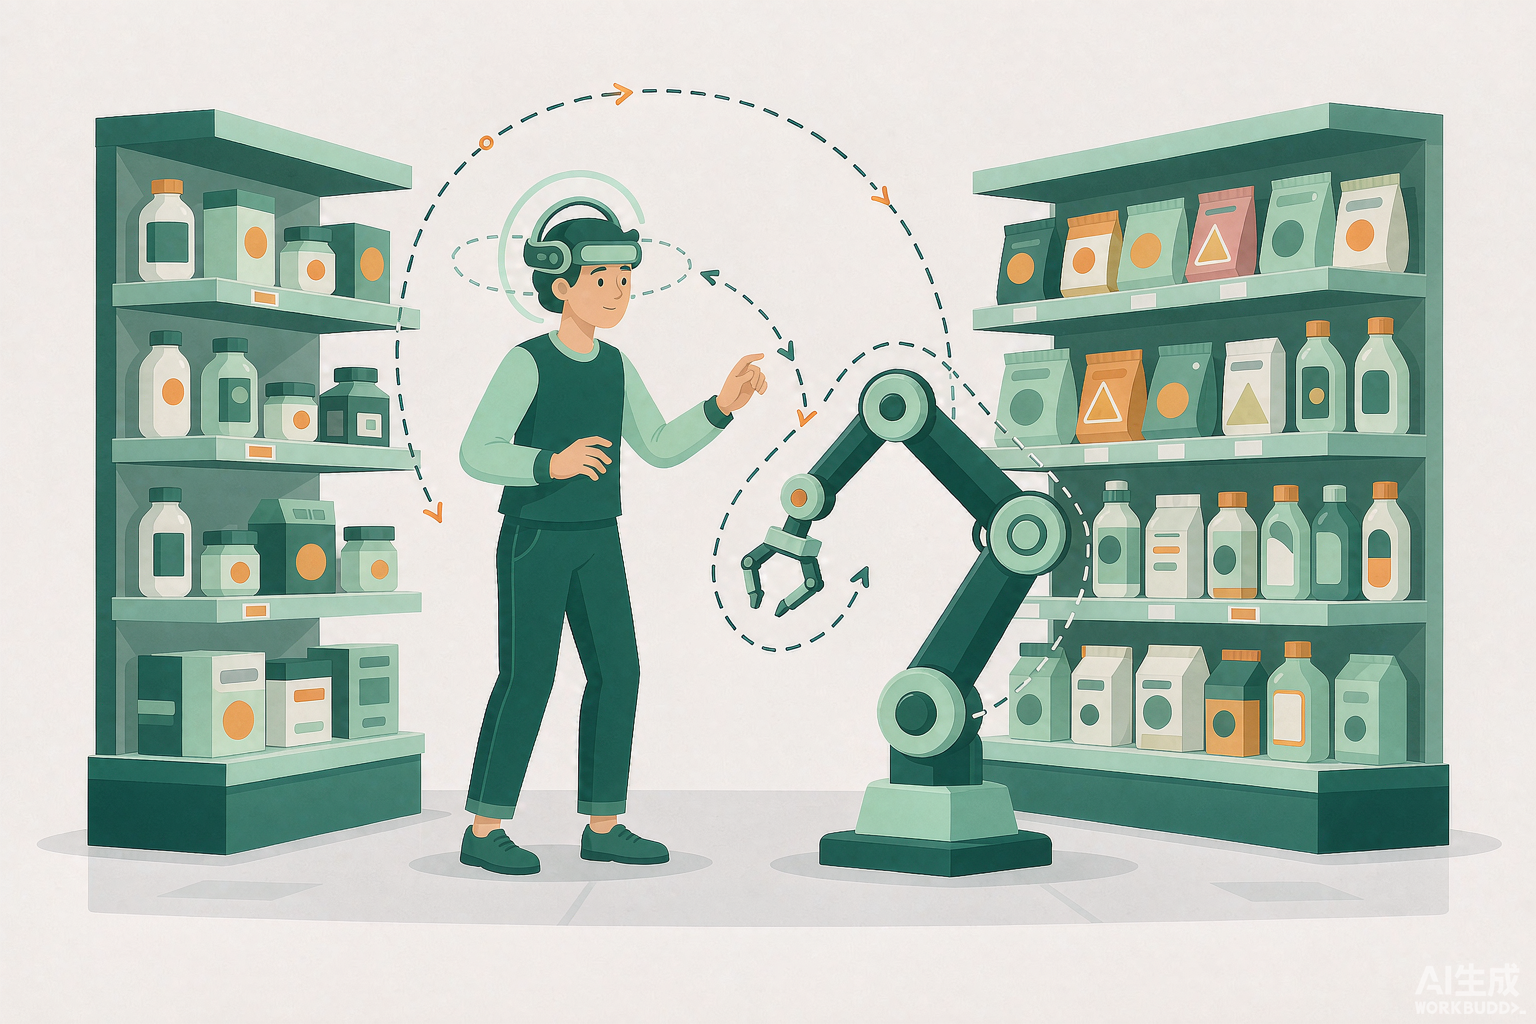
据湖北日报、长江日报等报道,基地依托社区药房、零售门店、餐饮后厨等真实场景,由劳动者佩戴轻量化采集设备,从第一人称视角记录双手与物品的互动;视频汇集到武汉后,先通过语义标注说明「人在做什么、动作何时发生」,再经轨迹重建还原手的移动与接触过程,形成可供模型训练的数据集。实验室里还设置了厨房、商超零售、药房分拣等七大应用场景供参观与验证。
目前采集已覆盖药房、超市、制衣厂、洗衣房等 1100 多个真实产业场景采集点。报道里提到的一个细节很有代表性:河南许昌一位宝妈在做家务的同时记录操作过程,每天可获得 140 至 180 元收入;基地方面介绍,82% 的采集人员来自原岗位,不按剧本摆拍、不刻意放慢动作,为的是保留真实操作里的技巧和应变。
质量怎么把关
公开报道披露的做法包括:依托自研的具身智能数据采集框架 AoE 记录第一视角数据;用专用标注模型、多模型协作加人工复核提高标注质量;建立覆盖 2000 多款手机的机型库;自研联合重建算法同时分析相机运动、双手轨迹和接触关系,双目视频下手部关节位置重建误差约为 7 毫米;经三层质检,数据验收通过率保持在 95% 至 99%。这些数字均来自基地对外披露,尚未见第三方复核,读者可把它当作参考量级。
对标注从业者意味着什么
- 标注对象变了。从静态图片里的框,变成连续视频里的时间段、动作单元、接触事件和轨迹点;要判断的常常是「这个动作从哪一帧开始算」。
- 规范更难写。遮挡、视角变化、同一动作的不同做法,都需要在规范里事先约定,否则一致性很难看住。
- 现场经验更值钱。懂药房分拣、懂后厨流程的人,能判断哪一步是「关键动作」,这类判断短期内不容易被纯自动化替代。
想往这个方向转的团队,可以先从一件小事练起:拿一段连续操作视频,试着写出「动作单元 + 起止帧 + 接触对象 + 判断依据」四件套,再让两个人独立标一遍对一致性。这比先买设备更划算。
本文为公开报道整理,数据均引自基地对外披露与媒体报道,非本站实测。
参考来源
数据来自基地对外披露与媒体公开报道
数据标注入门指南
按「是什么 → 怎么标 → 怎么验 → 怎么选工具 → 怎么算成本」串起站内的实操文章。