
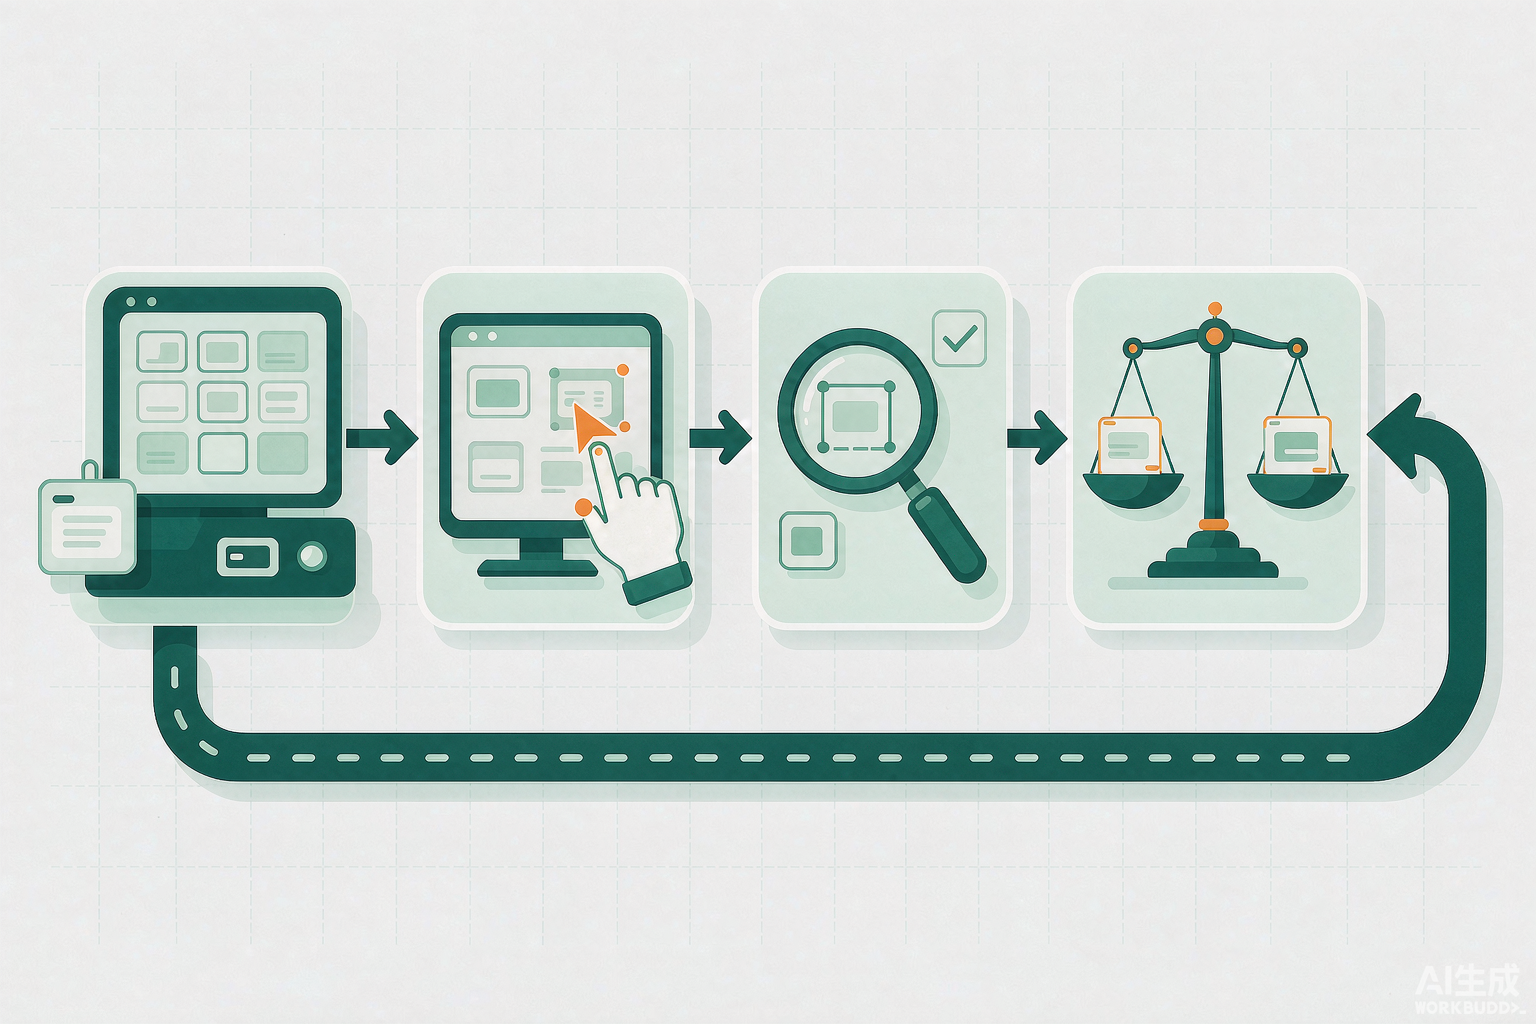
模型预标注 + 人工校准:一套能落地的质检流程
政策点名了三种人机协同标注模式,但真正难的是流程怎么跑:抽检怎么分层、一致性怎么看、争议谁仲裁、返工怎么闭环。这篇给一套可以直接照着改的流程。
《关于推进行业高质量数据集建设行动的实施方案》第(五)条点名了「模型预标注+人工校准」「人工标注+模型检验」「模型预标注+模型检验」三种智能化标注服务。方向没有争议,但落到项目上,很多团队一用预标注就翻车:要么把校准做成全量复核,省不下进行;要么直接信模型输出,验收时被成片退单。
问题通常不在模型,而在质检流程没跟着换。下面这套流程是方法整理,不含任何行业统计数字,可按项目规模增删。
先分清:校准不等于复核
- 校准:针对模型输出,判断哪里对、哪里错、错在哪类,并修正;重点是「判断」,不是「重画一遍」。
- 复核:针对人工标注结果,再检查一遍;重点是「查漏」。
- 抽检:从已完成批次里按规则抽一部分,用来估计整体质量、决定能不能放行。
把三件事混在一起,最直接的后果是成本没降、责任也不清。建议在项目启动时就把三种动作的定义、执行人和留痕方式写进规范。
六个环节,每个都要留记录
| 环节 | 做什么 | 必须留下的记录 |
|---|---|---|
| ① 预标注 | 模型跑全量,输出框/标签与置信度 | 模型版本、参数、运行批次号 |
| ② 分层抽样 | 按标注员、类别、置信度区间分层,不随机一把抓 | 抽样规则与样本清单 |
| ③ 人工校准 | 对低置信度、新类别、新人的结果重点判断并修正 | 修正前后对照、修正原因分类 |
| ④ 一致性检验 | 同一批样本由两人独立标注,比较差异 | 一致率计算口径、分歧样本清单 |
| ⑤ 争议仲裁 | 由规范负责人或业务专家裁定,并回写规范 | 仲裁结论、规范变更记录 |
| ⑥ 返工闭环 | 按错误类型定向返工,而不是整批重来 | 返工范围、复检结果、结项报告 |
抽检怎么分层才有用
均匀随机抽样最容易做,也最容易漏问题。经验上更有效的加权维度有四个:新上岗标注员的前几批、新增或刚改过的类别、模型置信度偏低的样本、以及历史返工率高的任务类型。给这几类加权重,能在相同抽检量下发现更多真问题。具体比例没有通用答案,建议用前两三批的数据把比例调出来,再固定成规则。
一致性指标别只看一个数
常见做法是两人独立标注同一批样本,计算一致比例。这个数好用,但有三点要注意:类别不平衡时它容易虚高;分歧集中在少数难例时,平均值会掩盖问题;规范改版前后的数不能直接比。更实用的做法是同时看分歧样本清单和错误类型分布——前者告诉你要改哪条规范,后者告诉你要补哪段培训。如果团队熟悉 Cohen's Kappa 一类的一致性系数,也可以作为补充,但别把它当成唯一验收依据。
争议仲裁的三个约定
- 先建一小份「黄金集」:由业务方确认的标准答案样本,规范解释不清时以它为准;
- 仲裁不靠谁资历老,靠写下来的理由;每次仲裁都要产出一条规范补充说明或示例;
- 规范要带版本号,标注员看到的永远是当前版本,旧版本归档留存。
最容易踩的四个坑
- 置信度阈值直接照搬别的任务,没有用自己前几批数据校准;
- 模型升级了但批次记录没跟上,出问题无法回溯是哪一版跑的;
- 返工只改结果不分类原因,同样的错下一批继续出现;
- 规范口头传达,仲裁结论没回写,新人继续踩同一个坑。
最后给一个最小可行起步方式:不必一次上全套。先做「分层抽样 + 分歧样本清单 + 规范版本号」这三件,跑一个批次看效果,再决定要不要加一致性系数和黄金集。流程是长出来的,不是一次设计完美的。
本文为方法论整理,不含行业统计数据;政策表述引自国家数据局《实施方案》第(五)条,具体比例与阈值需按项目自行验证。
参考来源
方法论整理,非新闻;政策背景已标出处
数据标注入门指南
按「是什么 → 怎么标 → 怎么验 → 怎么选工具 → 怎么算成本」串起站内的实操文章。